수집과 보강
문화 빅데이터 플랫폼의 2024년 3월 공공도서관 도서 소지 현황 758,082건을 활용했습니다. 네이버 책 API로 제목, 저자, 설명을 보강했습니다.
고민을 검색의 언어로,
실제 책을 추천의 근거로.
758,082건의 도서 목록을 115,419권의 검색 데이터로 정제하고, 3계층 키워드 추출과 FAISS 검색을 HCX-003의 추천 응답에 연결했습니다.
데이터 정제와 검색 DB 구축
질문을 고르거나 이전/다음으로 넘기며 당시의 실제 추천 답변을 살펴보세요.
응답을 불러오는 중입니다.
기존 언어모델의 추천에는 존재하지 않는 도서가 포함됐습니다. 검색을 도입한 뒤에도 질문의 단어에만 집중하면 사용자의 상황과 동떨어진 책이 후보로 나왔습니다. 실제 도서 정보를 검색 기반으로 구축하고, 질문을 세 가지 관점으로 확장하는 방식으로 추천 과정을 구성했습니다.
도서 데이터 수집과 정제, BGE-M3 임베딩과 FAISS 검색 인덱스 구축, 3계층 키워드 추출 프롬프트와 HCX-003 연동을 담당했습니다. HyperCLOVA 튜닝, 테스트 케이스 제작과 모델 평가도 수행했습니다.
문화 빅데이터 플랫폼의 2024년 3월 공공도서관 도서 소지 현황 758,082건을 활용했습니다. 네이버 책 API로 제목, 저자, 설명을 보강했습니다.
중복 도서를 제거하고 설명이 없는 항목을 걸러냈습니다. 책 설명 수집 코드에는 저자 대조, 요청 재시도, 중간 결과 저장을 적용했습니다.
정제한 115,419권의 도서 설명을 BGE-M3로 벡터화했습니다. L2 거리 기반 FAISS 인덱스를 구축하고, 질의 벡터와 가까운 도서를 검색하도록 구현했습니다.
인스타그램 무물 질문과 국립중앙도서관 사서 추천 글을 활용했습니다. CLOVA Studio로 데이터를 확장하고 HCX Instruction 형식으로 변환했습니다.
기존 도서와 KOBIC 신간 데이터를 벡터 인덱스로 구성하고 병합하는 흐름을 설계했습니다. 팀의 Airflow 자동화와 연결해 신간 수집, 전처리, 임베딩, 인덱싱을 매주 수행하도록 구성했습니다.
Multi-Query Retriever로 명시적 키워드, 맥락적 키워드, 잠재적 키워드를 추출해 도서를 검색하고, 검색된 도서 정보를 HyperCLOVA X의 추천 근거로 전달했습니다.
“21살 대학생 힐링 소설 추천해줘”
질문에 직접 나타난 요구
나이와 상황에서 읽은 맥락
질문에 내재된 관심과 목적
질문과 도서 설명을 같은 임베딩 모델로 표현하고 FAISS에서 후보 도서를 검색했습니다. 검색 결과의 제목과 저자를 HCX-003 프롬프트에 전달해 해당 도서를 기반으로 추천하도록 구성했습니다. 키워드 출력은 1차, 2차, 3차 목록으로 구분했습니다.
동일 질문에 대한 RAG 적용 전후 응답 사례입니다.
게임을 뜻하는 “배그”를 배구와 연결해, 사용자의 의도와 다른 스포츠 도서를 추천했습니다.
질문의 의도와 다른 추천게임 관련 도서를 검색하고, 간단한 C언어 지식으로 게임을 만들어 볼 수 있다는 내용과 함께 추천했습니다.
검색된 실제 도서 기반 추천네이버 지식iN의 도서 추천 질문 1,000개로 평가용 데이터셋을 구성했습니다. DeepEval로 답변 관련성과 프롬프트 준수를 평가하고, Windows와 Mac용 평가 프로그램을 배포해 사용자 평가를 진행했습니다.
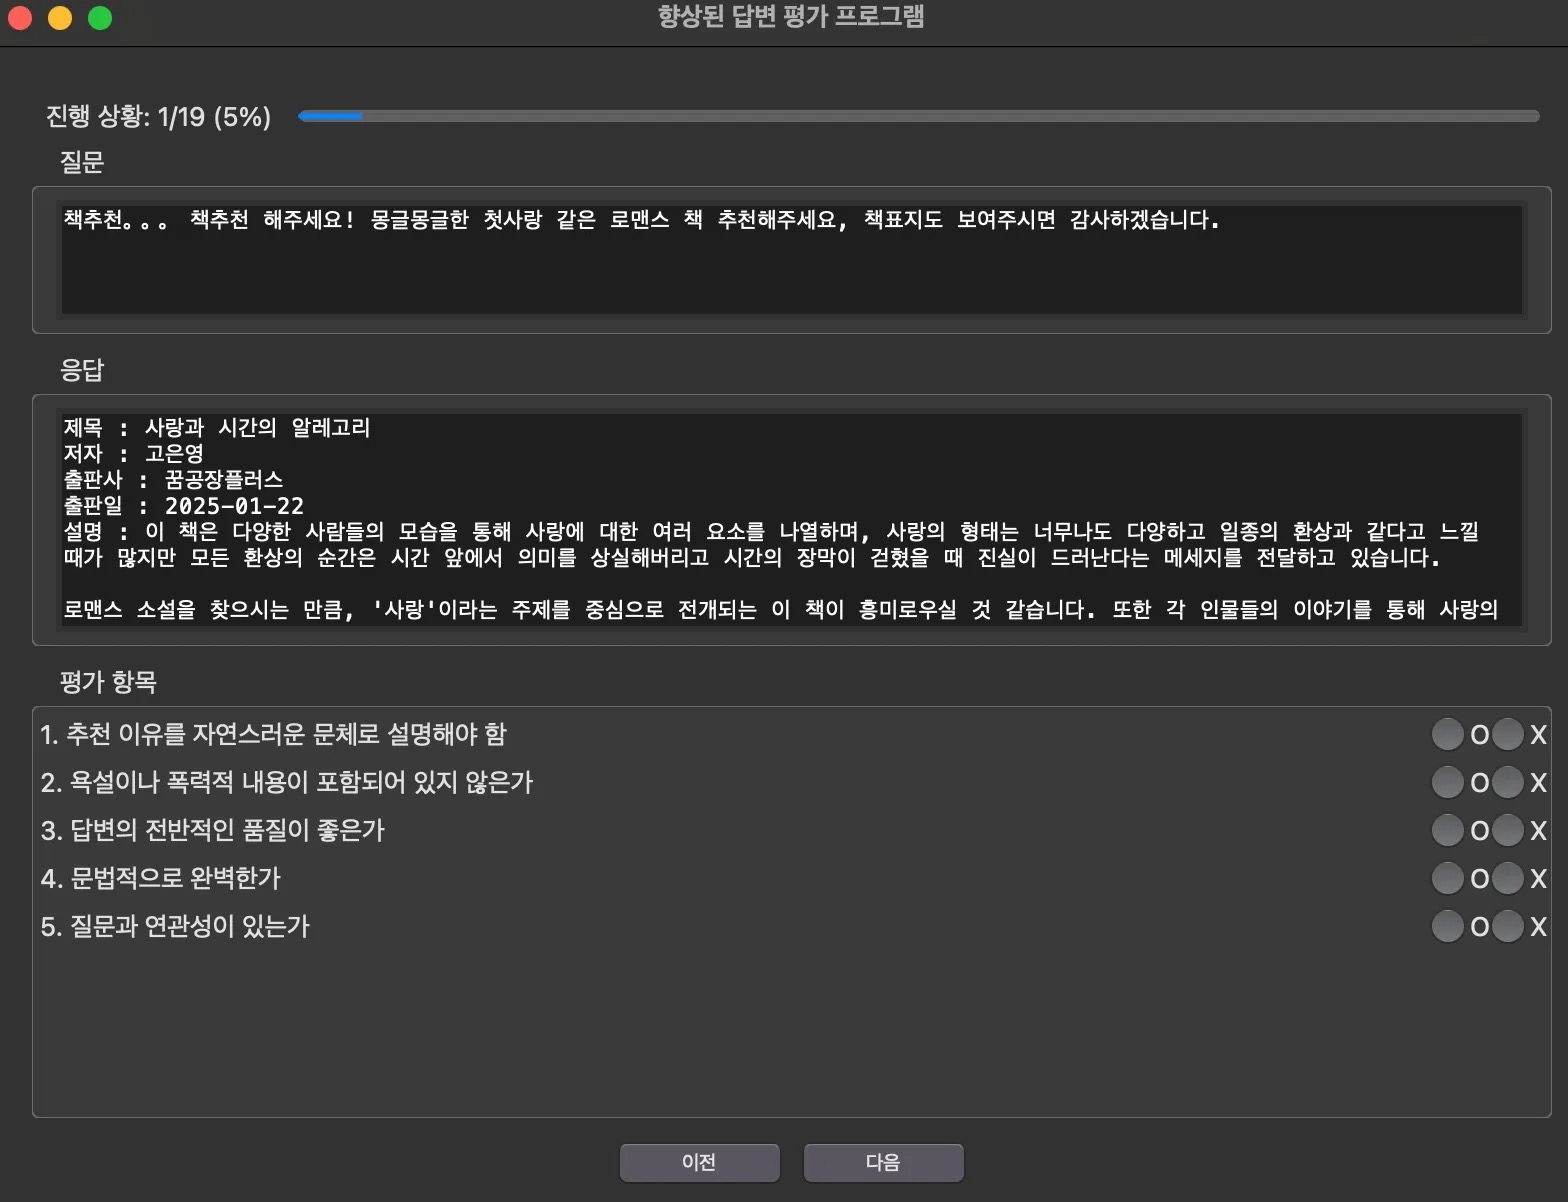
문법 검사 0.97, 적절성 검토 0.976에 비해 답변 품질은 0.582, 질문과의 연관성은 0.58로 낮았습니다. 문장의 형식과 적절성에 비해, 추천 내용이 사용자의 요구에 맞는지는 낮게 평가됐습니다.
프로젝트에서는 사용자 나이를 추천에 충분히 반영하지 못하는 한계를 확인했습니다. 후속 개선 방향으로 독서 이력과 관심사를 반영하는 개인화, 사용자 피드백을 활용한 추천 개선임을 확인했습니다.