검출과 임베딩의 역할을 분리
InsightFace로 얼굴을 검출하고 정렬한 뒤 AdaFace로 임베딩을 추출했습니다. 같은 인물의 사진은 코사인 거리 기반 Agglomerative 군집화로 묶었습니다.
사진을 찾는 말과,
사진 속 정보를 연결하다.
얼굴과 장면을 구조화하고, 자연어를 날짜와 장소, 인물과 활동 조건으로 바꾸는 사진 검색 서비스. 2인 팀의 대표로 AI 코어와 데이터 파이프라인, 검색 백엔드를 설계했습니다.
얼굴 크롭 1,500장 실험 / 재검출 성공률
작게 잘린 얼굴을 다시 검출하는 단계에서 다수의 크롭이 누락됐습니다. InsightFace와 AdaFace를 유지하면서 검출 전 여백을 추가하고, 최초 검출의 랜드마크를 정렬에 재사용하도록 바꿨습니다.
입력 크롭 구조 도식
얼굴 바깥에 반사 여백을 더해 재검출 입력을 구성했습니다. 실험의 재검출 성공률은 70.5%였습니다.
InsightFace로 얼굴을 검출하고 정렬한 뒤 AdaFace로 임베딩을 추출했습니다. 같은 인물의 사진은 코사인 거리 기반 Agglomerative 군집화로 묶었습니다.
작은 얼굴 크롭이 프레임을 가득 채우는 입력을 확인했습니다. 검출 전에 reflect padding을 추가해 재검출 성공률을 22.7%에서 70.5%로 개선했습니다.
최초 검출에서 얻은 얼굴 랜드마크를 저장하고 정렬에 바로 사용했습니다. 랜드마크가 없는 크롭에만 여백을 추가한 재검출을 적용했습니다.
관계 문장의 벡터 검색을 시도했지만, 같은 사건에 대한 LLM의 서술 편차로 군집이 과도하게 나뉘었습니다. 이후 질문을 구조화하고 날짜 → 장소 → 인물 → 활동과 객체 순서로 조건을 적용하는 검색 흐름을 구현했습니다.
“2020년 비행기에서 찍은 사진”
연도가 있는 요청은 시작일과 종료일로, “12월”처럼 연도가 없는 요청은 월 조건으로 변환했습니다.
등록된 인물 이름을 인물 ID와 연결하고 사진별 인물 매핑을 사용해 후보를 필터링했습니다.
“모자 쓴”은 객체 조건으로, “산책”은 활동 조건으로 다룹니다. 저장된 설명과 태그를 바탕으로 어휘 매칭과 LLM 의미 매칭을 적용했습니다.
얼굴 임베딩과 장면 분석은 작업 큐에서 처리하고 결과를 저장했습니다. 이후 검색에서는 분석 결과를 재사용하도록 API 서버와 AI 처리 서버를 분리했습니다.
인물의 시각적 특징과 장면의 객체, 활동, 환경 정보를 구조화합니다.
동일 인물의 관찰을 시간순으로 묶어 반복되는 활동과 등장 패턴을 분석합니다.
PersonZeroProfiler의 사용자 프로필과 관찰, 패턴을 함께 사용해 관계 정보를 생성합니다.
관계 정보는 모델이 추론한 값으로 저장됩니다.
인물 사진 주변의 촬영 시각과 위치를 비교해 풍경과 음식 사진도 맥락에 함께 연결했습니다.
관계 문장의 벡터 검색
날짜, 장소, 인물, 활동 조건 검색
초기에는 사진을 객체, 속성, 관계로 나누어 설명하고 관계 문장을 BGE-M3로 임베딩했습니다. 사용자가 기억하는 상황을 사진 속 관계와 연결하려는 접근이었습니다.
같은 사건도 LLM의 서술에 따라 다른 군집으로 나뉘었습니다. 장소 가중치를 추가했지만 넓은 장소의 사진이 분리되고, 장소명과 도로명 주소의 표현 차이가 남았습니다.
질문을 날짜, 장소, 인물, 활동과 객체로 분해해 저장된 정보에 조건을 적용하는 검색으로 전환했습니다. 좌표는 주소 정보로 변환하고 이름은 인물 ID와 연결했습니다.
분리와 병합 오류를 함께 비교
AdaFace + Agglomerative
정확한 촬영 시각을 기억하지 못해도 누구와 함께 있었는지는 기억할 수 있습니다. 시각 예측 실험 이후 인물과 관계를 검색의 주요 축으로 잡았습니다.
직접 분류한 얼굴 데이터로 DBSCAN, Agglomerative, PairwiseLink, Infomap, HDBSCAN을 비교했습니다. 동일 인물의 분리와 서로 다른 인물의 병합을 구분해 검토했습니다.
정밀도와 전체 군집화 성능을 함께 고려해 Agglomerative를 선택하고 AdaFace 임베딩을 적용했습니다. 저품질 얼굴과 많은 인물이 작게 등장하는 사진의 처리 기준도 조정했습니다.
타이트한 크롭에서 검출 누락
여백 추가 + 랜드마크 재사용
작게 잘린 얼굴을 다시 검출할 때 다수의 입력이 누락됐습니다. 얼굴이 프레임을 가득 채우는 크롭을 확인하고 주변 영역을 바꾸는 실험을 진행했습니다.
얼굴 크롭 1,500장에 반사 여백을 추가해 재검출 성공률을 22.7%에서 70.5%로 높였습니다. 이 지표는 얼굴 재검출 성공률입니다.
최초 검출의 랜드마크를 저장해 정렬에 재사용했습니다. 랜드마크가 없는 크롭에 여백을 추가한 재검출을 적용하도록 처리 흐름을 구성했습니다.
한 장의 사진만으로 관계 해석
관찰 → 패턴 종합 → 관계 추론
한 장의 사진 설명만으로 관계를 정하기에는 맥락이 부족했습니다. 동일 인물이 언제, 어떤 장면에 반복해서 등장하는지 함께 살펴보도록 구성했습니다.
이미지별 관찰, 동일 인물의 기록 종합, 사용자 기준 관계 추론으로 단계를 나눴습니다. 촬영 연도에 따른 나이와 등장 패턴을 관계 분석에 반영했습니다.
Observer가 장면을 구조화하고 Reasoner가 시간순 관찰을 종합합니다. PersonZeroProfiler의 사용자 정보와 이 결과를 SocialAnalyst에 연결했습니다. 관계는 모델의 추론값으로 저장됩니다.
인물이 있는 사진만 분석
180분 / 1km의 주변 사진 연결
식사나 여행에는 사람 사진뿐 아니라 음식과 풍경 사진도 남습니다. 인물이 있는 사진만 분석하면 주변 활동의 일부를 놓치게 됩니다.
촬영 시각과 위치를 비교해 180분 이내, 1km 범위의 주변 사진을 맥락에 연결하는 기준을 적용했습니다.
주변 장면과 활동 정보를 인물 분석에 함께 사용했습니다. 음식, 풍경, 사회적 활동과 연도별 기록을 프로필 및 라이프 화면에 연결했습니다.
사진 분석과 검색의 처리 분리
분석 결과 저장 → 검색에 재사용
얼굴 검출과 임베딩, 인물 매핑, 장면 및 관계 분석을 거쳐야 사진을 검색 가능한 상태로 만들 수 있습니다.
API 서버와 AI 처리 서버를 분리하고 사진 분석을 작업 큐에 전달했습니다. 얼굴 처리, 인물 매핑, 인물 분석, 장면 정보 분석을 연결했습니다.
검색에서는 질문을 구조화한 뒤 저장된 분석 결과를 필터링했습니다. 날짜와 장소, 인물, 활동 조건을 사진별 정보와 연결하는 백엔드를 구현했습니다.
이미지와 캡션을 결합한 표현에서 연중 날짜와 하루 중 시각을 예측하는 연구입니다. 데이터셋을 직접 연결해 구축하고, 레이어와 입력 구성을 비교한 뒤 주기성을 반영한 어텐션 예측기를 설계했습니다.
사진을 전달하거나 가공하는 과정에서 촬영 시각 정보가 사라지면, 원래의 시간 순서로 정리하거나 날짜로 검색하기 어려워집니다. 이 문제에서 출발해 조명, 그림자, 계절과 복장처럼 사진 안에 남아 있는 시각 단서를 활용하는 방법을 탐색했습니다.
TIGeR와 GT-Loc을 읽으며 이미지, 시간, 위치를 함께 표현하는 접근과 시간의 주기적 인코딩을 검토했습니다. 초기에는 시간 정보를 결합하는 Q-former 구조를 구상했고, 이후 촬영 시각 예측을 직접 검증하는 경량 프로브로 연구 범위를 구체화했습니다.
BLIP-2와 DeepSeek-VL2의 이미지-텍스트 결합 방식을 조사한 뒤, 정렬 모델을 처음부터 학습하는 대신 Qwen의 hidden state를 활용했습니다. 사전학습 모델에서 특징을 추출하는 과정과 시간 예측기를 학습하는 과정을 분리했습니다.
연도 자체를 맞히는 대신, 1년 안의 월과 일 그리고 하루 안의 시각을 두 개의 주기적 값으로 예측합니다.
학습에는 사진뿐 아니라 시간 단서를 설명하는 캡션과 정답 촬영 시각이 필요했습니다. COCO에는 이미지가 있지만 촬영 메타데이터가 제거되어 있어, 다른 데이터셋과 원본 이미지의 연결점을 찾았습니다.
118,287장 규모의 학습 이미지
상세 캡션을 연결한 50,027장
Flickr ID로 촬영 메타데이터 매칭
이미지 + 상세 설명 + 촬영 시각을 함께 갖춘 데이터셋
초기 개인 사진 2,143장에 경량 캡셔너를 적용했지만, 반복 표현과 이미지에 맞지 않는 설명이 발생했습니다. 이후 ShareGPT4V의 고품질 캡션을 활용하는 방향으로 데이터 구성을 변경했습니다.
수집 데이터의 연도, 월, 시간대, 요일과 위치 분포를 살펴봤습니다. 주간과 주말에 사진이 몰리고 겨울과 야간 사진은 상대적으로 적었습니다. 지역도 북미, 유럽, 동아시아에 집중되어 있었습니다.
Qwen의 hidden state를 레이어별로 추출하고 각 표현 위에 어텐션 예측기를 학습했습니다. Cyclic Loss를 비교했을 때 9, 11, 13, 19, 24번 레이어가 낮은 손실을 보였습니다.
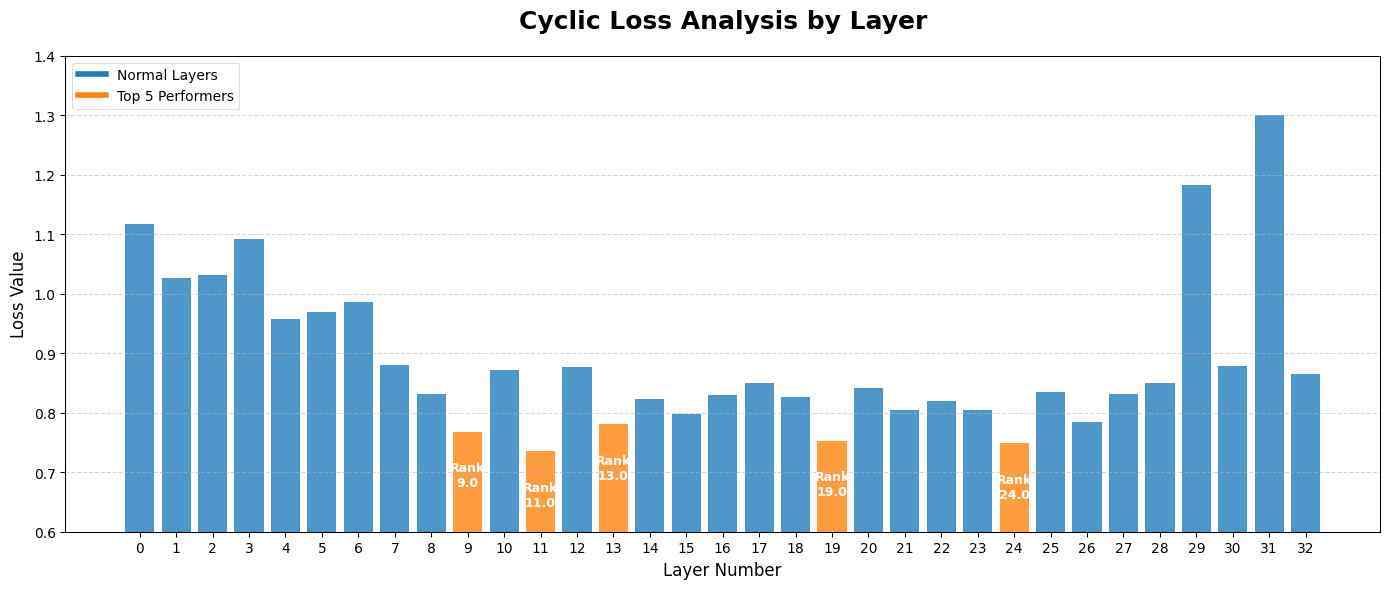
2,143장에 대한 전체 레이어 특징 저장에 164GB가 필요했습니다. 전체 데이터로 확장할 때의 저장 공간과 메모리 부담을 고려해 후보 레이어를 좁혔고, 최종 예측에는 9번 레이어를 사용했습니다.
중간 실험에서는 9, 19, 24번 레이어를 후보로 검토했습니다. 최종 파이프라인은 단일 레이어 특징과 Sequence Probe Model을 사용하는 형태로 구성했습니다.
이미지만 입력한 실험에서 학습 손실이 충분히 낮아지지 않는 양상을 확인했습니다. 이미지와 설명문을 함께 입력한 실험에서는 초기 학습 손실이 내려가는 것을 확인하고, 최종 입력에 캡션을 포함했습니다.
실험에서 관찰한 시퀀스 길이: 최대 208토큰
실험에서 관찰한 시퀀스 길이: 최대 642토큰
새 사진을 처리할 때는 Gemini로 장면 설명을 만들고 사진과 함께 Qwen에 입력했습니다. 캡션 프롬프트에는 빛의 방향, 그림자, 하늘과 복장 등 시간대와 계절을 파악할 수 있는 단서를 포함했습니다.
Qwen에서 선택한 레이어의 hidden state 추출
Linear → Tanh → Linear
패딩 토큰 마스킹 후 Softmax
각 토큰 특징에 어텐션 가중치를 곱해 합산
1024차원 은닉층 / ReLU / Dropout 0.2
연중 날짜 θ + 하루 중 시각 φ
사진과 설명문에 따라 토큰 길이가 달라지므로 배치 내 시퀀스를 패딩했습니다. 패딩 위치의 점수는 Softmax 전에 제외해 실제 입력 토큰만 가중합에 기여하도록 했습니다.
Qwen은 NF4 4bit로 로드하고 추출한 hidden state는 float16으로 저장했습니다. 이미지 크기를 조정하고 선택한 레이어만 사용하는 방식으로 특징 추출과 예측기 학습을 분리했습니다.
12월 31일과 1월 1일, 23시 59분과 0시 1분처럼 경계 양쪽의 가까운 시간을 학습 목표에서도 가깝게 다룹니다.
최종 검증 결과 4,173건에서 연중 날짜와 시각을 함께 비교한 평균 순환 오차는 75일 4시간 19분이었습니다. 날짜를 제외하고 하루 중 시각만 비교한 순환 MAE는 3.643시간입니다.
1년 주기로 계산한 평균 오차
24시간 주기로 계산한 평균 오차
막대를 누르면 해당 구간의 비중을 볼 수 있습니다.
실제 시각과 예측 시각 사이의 짧은 방향 거리를 계산했습니다. 각 구간은 하한 포함, 상한 미만이며 마지막은 12시간을 포함합니다.
순환 거리 2분
막대를 선택하면 표본 수와 평균 오차가 표시됩니다. 작은 화면에서는 차트를 좌우로 넘겨보세요.
6월과 7월 촬영 사진의 평균 연중 오차는 각각 약 37.3일과 31.5일이었고, 1월과 12월은 약 121.0일과 120.4일이었습니다. 전체 평균뿐 아니라 촬영 시기별로 결과를 나누어 한계를 확인했습니다.
시간대별 결과와 예측 사례를 확인하며 야간, 실내처럼 조명과 계절 단서가 약한 장면을 검토했습니다. 데이터의 시간대 편중과 시각적 단서의 부족을 후속 개선 과제로 정리했습니다.
큰 날짜 오차를 보인 사진의 촬영 위치를 확인하며 남반구와 적도 사례를 살펴봤습니다. 남반구에서는 북반구와 계절이 반대이고, 적도는 계절 변화의 양상이 달라 위치를 고려하지 않는 예측에 한계가 있었습니다.
GPS 위도가 −5°보다 낮은 경우 예측 날짜를 6개월 이동시키는 보정을 적용했습니다. 촬영 위치를 알 수 있는 경우에 사용하는 규칙입니다.
위도 보정에는 GPS가 필요하고 모든 지역의 계절 차이를 동일하게 설명하지 못합니다. 위치 정보와 시간 표현을 함께 학습하는 방법, 지역과 시간대별 데이터 균형을 개선하는 방향을 후속 과제로 정리했습니다.
날짜가 가까운 예측과 날짜 오차가 큰 예측을 함께 비교했습니다.
| 장면 | 실제 촬영 | 예측 | 관찰 |
|---|---|---|---|
| 놀이공원 | 03-19 15:25 | 03-19 14:31 | 같은 날짜 / 54분 차이 |
| 호숫가 | 05-25 14:18 | 05-26 13:32 | 다음 날짜로 예측 |
| 잎 없는 나무 | 04-01 16:43 | 02-28 14:27 | 약 한 달 앞선 날짜 |
| 강변과 구름 | 06-06 17:33 | 05-21 13:27 | 약 16일 앞선 날짜 |
| 겨울 강가 | 01-05 11:35 | 03-23 13:53 | 겨울을 봄으로 예측 |
데이터 생성, 임베딩 추출, 학습, 추론과 결과 분석을 하나의 파이프라인으로 구성했습니다. 새 사진은 캡션 생성과 특징 추출을 거쳐 날짜와 시각을 예측하고, 실제 촬영 시각이 있으면 비교 결과를 함께 저장하도록 구현했습니다.
평균 날짜 오차가 크고 데이터 분포에 따른 성능 차이가 남았습니다. 이 결과를 바탕으로 촬영 시각 예측은 별도 연구로 이어가고, Lumina의 사진 검색에는 인물과 장면 분석을 중심으로 적용했습니다.